Werkstattbericht Content-Automatisierung – Teil 5 von 8. Wie ich für einen meiner Blogs die Beitragsproduktion mit n8n und Claude automatisiert habe: was funktioniert hat, was nicht, und was am Ende dabei herauskam. Zu den anderen Teilen: 1 · 2 · 3 · 4 · 5 · 6 · 7 · 8.
Es gibt einen Ankertext in meinen Entwürfen, der mich verfolgt. Er lautet:
„Jagdem pflicht um“
Das ist kein Deutsch. Das ist auch kein Tippfehler. Das ist eine Wortfolge, die aus einem URL-Slug zusammengesetzt wurde, weil in einem Prompt stand, der Ankertext solle „derived from the URL“ sein.
Im selben Beitrag – „Effektive Wildregulierung“ – stand fünfmal derselbe interne Link, mit fünf verschiedenen Ankertexten. In einem anderen Beitrag zweimal derselbe Link mit dem Ankertext „hier“. Und in dem Beitrag über Wildbrethygiene hing mitten in einem Absatz über Kühltemperaturen dieser Satz:
„…um die Aromen im Fleisch voll auszubilden. Survival Guide für Anfänger bietet zusätzliche Einblicke, wie man in der Wildnis hygienisch arbeitet.“
Ein Beitrag über Survival-Grundlagen hat mit Wildbretkühlung nichts zu tun. Der Link stand da, weil der Prompt einen verlangte.
Dies ist Teil 5 des Werkstattberichts, und es ist der Teil, in dem ich zum ersten Mal etwas herausgerissen und komplett neu gebaut habe.
Fünf Links, ein Ziel
Was die Vorlage mit Verlinkung meinte
Der Mechanismus der Vorlage war denkbar einfach: Sitemap holen → URLs herausschneiden → die ersten 50 nehmen → in die Prompts der Copywriter geben. Dort stand sinngemäß:
„Wähle eine URL, die zum Kapitel passt, und binde sie mit sinnvollem Ankertext ein. Jede URL nur einmal. Wenn keine passt, setze keinen Link.“
Klingt vernünftig. Ist es auch – auf dem Papier.
In der Praxis erzeugte es maximal einen Link pro Kapitel, dafür aber Ankertexte wie den oben. Und die Regel „jede URL nur einmal“ konnte gar nicht greifen.
Warum kein Prompt der Welt das repariert
Das ist der eigentliche Befund dieses Teils, und er ist unabhängig davon, welches Modell du einsetzt.
Was der Copywriter zu sehen bekam, war eine Liste nackter URLs:
https://wildnisruf.de/survival-in-der-wildnis-der-ultimative-guide-fuer-anfaenger/
…Das Modell weiß nicht, worum es in diesen Beiträgen geht. Es sieht eine Zeichenkette und rät. Genau daher stammt der Link im Wildbret-Beitrag: Der Slug enthält „survival“, „guide“, „anfaenger“ – klingt allgemein genug, passt also scheinbar überall.
Dazu drei weitere Konstruktionsfehler, die zusammenwirken:
- Jeder Unterkapitel-Copywriter läuft isoliert. Bei drei Kapiteln mit je zwei Unterkapiteln sind das sechs getrennte Modellaufrufe, von denen keiner weiß, was die anderen fünf gerade verlinkt haben. Die Regel „jede URL nur einmal“ ist damit nicht umsetzbar – nicht schwer, sondern unmöglich. Daher fünfmal dieselbe URL.
- Der Ankertext soll aus der URL abgeleitet werden. Daher „Jagdem pflicht um“.
- Es wird immer ein Link verlangt. Wenn nichts passt, wird trotzdem verlinkt.
Wenn du aus diesem Teil eine Sache mitnimmst, dann diese: Prüf bei jeder Prompt-Regel, ob der Aufruf sie überhaupt einhalten kann. Eine Anweisung an ein Modell, das die nötige Information nicht hat, ist keine Regel. Sie ist ein Wunsch.
Der Denkfehler, den ich selbst gemacht habe
Der Hub ist keine magische Seite
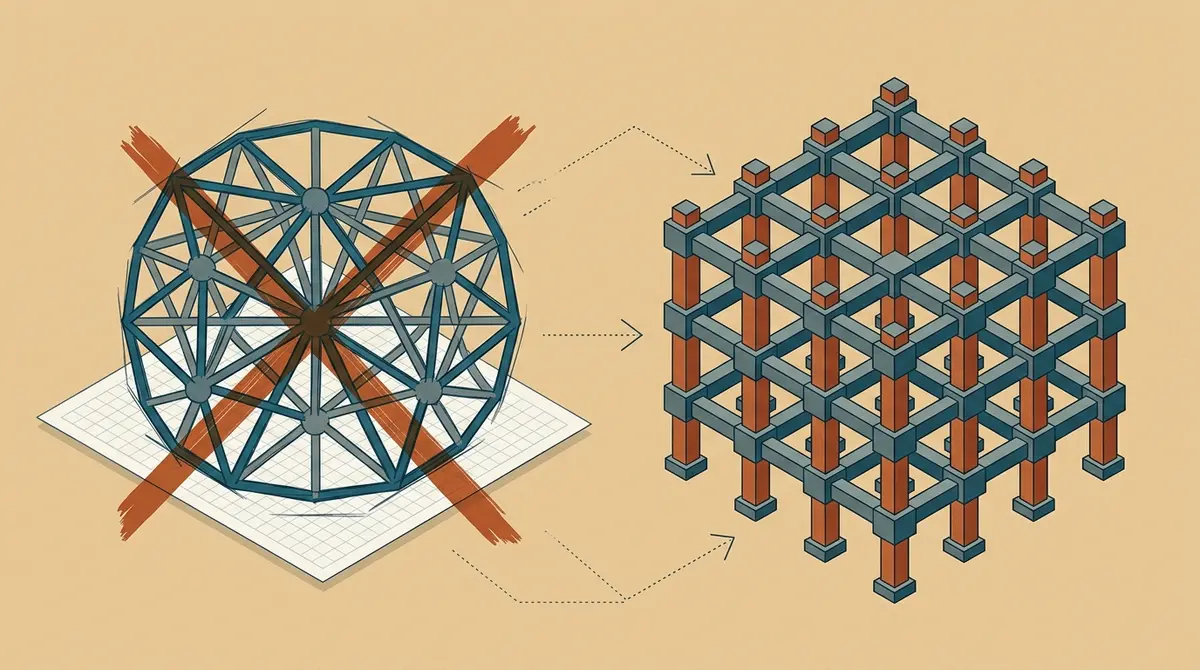
Ich hatte am Tag zuvor mit Claude ein Clustermodell für die Seite erarbeitet: Themengruppen, jede mit einem Hub-Beitrag in der Mitte, darum herum die Spokes. Und der naheliegende Vorschlag lautete, die Verlinkung genau daran aufzuhängen – jeder Beitrag verlinkt verbindlich auf seinen Hub plus zwei Nachbarn.
Ich habe widersprochen, und ich halte den Einwand bis heute für richtig:
Der Hub ist keine magische Seite. Er ist eine Seite wie jede andere. Sein einziger Vorteil ist, dass viele Links auf ihn zeigen. Wenn er selbst schwach ist, verteilt er Schwäche.
Vor allem aber ist eine Verlinkung, die jeden Beitrag zuerst auf seinen Hub zwingt, eine Hierarchie, die es im Suchverhalten meiner Leser gar nicht gibt. Wer über „Rucking bei Hitze“ liest, will als Nächstes „Rucking im Sommer“ – nicht die Cluster-Übersicht.
Claude hat mir daraufhin recht gegeben, und zwar mit einer Begründung, die ich hier zitiere, weil sie präziser ist als meine eigene: „Ich habe das im Cluster-Memo als Einschätzung gekennzeichnet – aber ich habe daraus trotzdem eine Architektur gebaut, und das war der Fehler.“
Der Cluster ist geblieben, was er von Anfang an gut konnte: Redaktionsplan. Dublettenprüfung, Veröffentlichungsreihenfolge, Übersicht über 1.121 Beiträge. Als Verlinkungsmechanik ist er gestrichen.
Exkurs: was belegt ist und was Auslegung
An dieser Stelle ist mir die Unterscheidung wichtig, weil im SEO-Bereich beides gern vermischt wird.
Belegt ist: Interne Links helfen Suchmaschinen beim Auffinden von Seiten und übertragen Signale. Der Ankertext ist ein Relevanzhinweis. Das ist unstrittig.
Auslegung ist: dass eine Hub-Struktur als solche besser rankt als ein Netz. Dafür kenne ich keine Aussage von Google. Wer dir das als Tatsache verkauft, verkauft dir eine Meinung.
Und zu den Antwortmaschinen – hier bin ich unsicher, bitte als Einschätzung lesen: Systeme wie KI-Suchantworten arbeiten meines Wissens nicht über den Linkgraphen, sondern rufen einzelne Textabschnitte über deren Bedeutungsähnlichkeit zur Frage ab. Wenn das stimmt, folgt daraus etwas Unerwartetes: Für die Zitierbarkeit zählt weniger, wohin ein Abschnitt verlinkt, als ob er für sich allein verständlich ist – ob er sein Thema beim Namen nennt statt „dies“ und „dieser Ansatz“ zu schreiben, ob er einen definierenden Satz enthält, ob er konkrete Zahlen und Eigennamen trägt. Mein Wissensstand dazu ist begrenzt und das Feld verändert sich schnell.
Der Neubau: Verlinkung als eigener Arbeitsschritt
Der Kern der neuen Lösung ist ein einziger Gedanke: Verlinkung ist kein Nebenprodukt des Schreibens mehr, sondern ein eigener Schritt am fertigen Artikel.
Kapitel schreiben (ohne Links)
        ↓
Artikel zusammensetzen  →  Bereinigung
        ↓
Interne Links planen   ← verwandte Beiträge mit Titel und Anriss
        ↓
Links einfügen         ← wörtliche Ersetzung, mit Prüfungen
        ↓
Markdown → HTML → WordPress
Vier neue Nodes. Die Sitemap-Kette ist damit funktionslos geworden.
Der Workflow lernt, was auf der Seite steht
Der erste neue Node holt die veröffentlichten Beiträge nicht mehr aus der Sitemap, sondern über die WordPress-REST-API:
/wp-json/wp/v2/posts?_fields=id,link,title,excerpt,categoriesmit automatischer Seitenweiterschaltung bis 20 Seiten, also 2.000 Beiträge.
Der Unterschied ist fundamental: Statt nackter URLs stehen jetzt Titel und Anriss zur Verfügung. Das Modell muss nicht mehr raten, worum es in einem Zielbeitrag geht – es liest es.
Nebenbei behebt das beide Konstruktionsfehler der Sitemap-Kette auf einen Schlag: kein Limit auf 50, keine Sortierung nach den ältesten Beiträgen.
Verwandtschaft ausrechnen
Der zweite neue Node bewertet jeden veröffentlichten Beitrag gegen das Thema des neuen Artikels und gibt die acht nächstliegenden weiter. Er hat drei Bestandteile, und alle drei sind der deutschen Sprache geschuldet:
- Gewichtete Wortüberschneidung. Seltene Wörter zählen mehr als häufige – „Wildbrethygiene“ wiegt schwerer als „Guide“. Treffer im Titel zählen doppelt, und der Teil vor dem Doppelpunkt dreifach, weil dort bei Ratgebertiteln das eigentliche Suchwort steht.
- Zeichen-Vierergramme. Reiner Wortvergleich scheitert am Deutschen, weil wir alles zusammenschreiben und flektieren. Vierergramme fangen „Wanderweg“ / „Wanderwege“ / „Wanderwegen“ ab.
- Komposita-Teiltreffer ab sieben Zeichen, damit Wildbrethygiene und Wildbret als verwandt erkannt werden.
Dazu zwei Schwellen: eine absolute und eine relative – nichts unter 35 % des besten Treffers. Findet sich nichts, gibt der Node eine leere Liste zurück, und dann wird nicht verlinkt. Das ist ausdrücklich ein zulässiges Ergebnis, und es ist der Unterschied zwischen einer Verlinkung und einer Verlinkungspflicht.
Getestet habe ich das nicht an einem Beispiel, sondern gegen alle 1.121 geplanten Titel – also gegen das, was die Seite in achtzig Wochen sein wird:
| Artikel | die drei nächsten Beiträge |
|---|---|
| Rucking bei Hitze | Rucking im Sommer: Hitze, Flüssigkeit und Scheuerstellen · Laufen bei Hitze: Warum der Wald die bessere Wahl ist · Desert-Trailrunning: Sand, Hitze und Gamaschen |
| Laufen auf Schotterwegen | Laufen auf losem Untergrund: Sand, Schotter und Geröll · Laufen auf Schnee: Tritt, Tempo und Grip · Rucking auf Schotter |
| Wanderschuhe einlaufen | Schuhe für die Fernwanderung: Einlaufen, Ersatz und Reparatur · Woran erkenne ich, dass Wanderschuhe ausgetreten sind? · Rucking-Schuhe: Wanderschuh, Trailrunner oder Turnschuh? |
| Wildbrethygiene | Die zehn Gebote der Wildbrethygiene — und sonst nichts |
Die letzte Zeile ist mir die wichtigste. Der Node hätte acht Kandidaten liefern dürfen und hat einen geliefert, weil kein weiterer die Schwelle erreichte. Genau so soll es sein. Die alte Mechanik hätte an derselben Stelle irgendeine der ersten 50 Sitemap-URLs genommen – vermutlich wieder den Survival Guide.
Ein Nebenbefund, mit dem ich nicht gerechnet hatte: Beiträge mit sehr hohem Verwandtschaftswert sind keine Linkziele, sondern Dubletten. Der Node meldet sie in einem eigenen Feld. Im Test schlug er an bei „Feuer machen ohne Feuerzeug: 5 Methoden, die auch bei Nässe klappen“ gegen „…die auch bei Nässe funktionieren“ – einem Paar, das mir bei der Planung durchgerutscht war.
Sechs Prüfungen, bevor ein Link gesetzt wird
Wer plant, und wer setzt
Die Arbeit ist bewusst auf zwei Nodes verteilt, und die Trennung ist der Kern der Sache:
Ein Sprachmodell plant. Es sieht den fertigen Artikel und die acht Kandidaten mit Titel und Anriss, und es wählt drei bis sechs Stellen. Es liefert ausschließlich Paare aus Ankerphrase und URL zurück – es schreibt den Artikel nicht um. Weil es den ganzen Text sieht, kann es das, was vorher unmöglich war: Links über verschiedene Abschnitte verteilen und jede URL nur einmal verwenden.
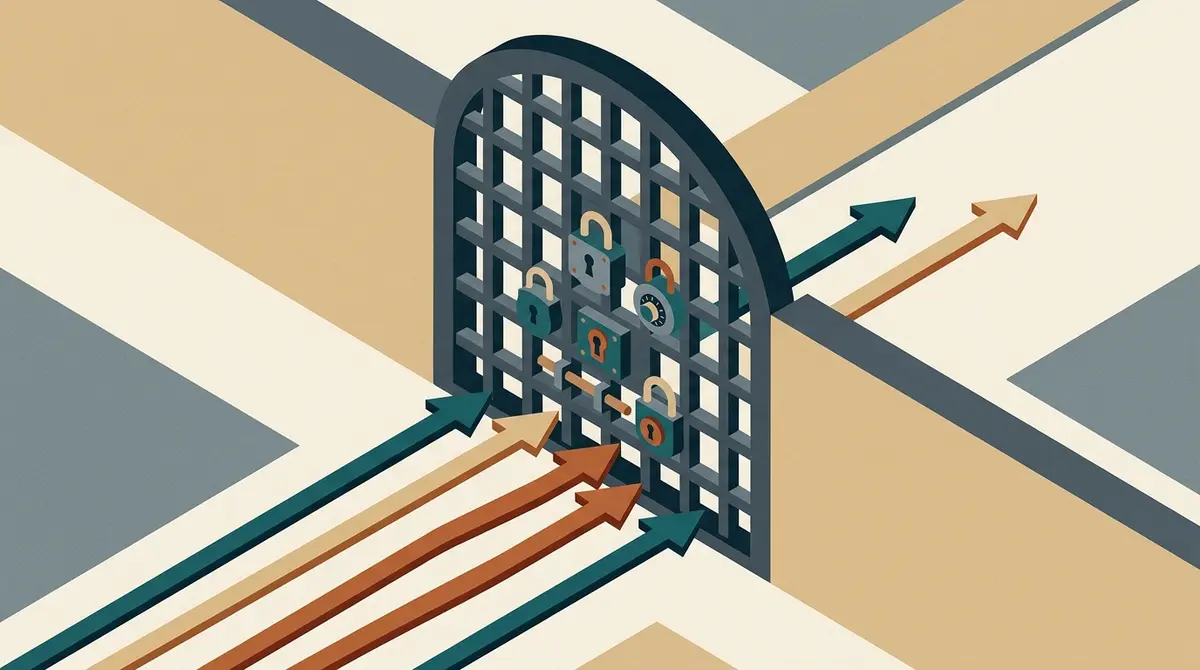
Ein Code-Node setzt ein. Er ersetzt die Ankerphrase wörtlich im Text – und verwirft jeden Vorschlag, wenn
- die Phrase nicht buchstabengenau im Artikel steht (verhindert erfundene Sätze),
- sie in einer Überschrift liegt,
- die URL nicht aus der Kandidatenliste stammt (verhindert erfundene Links),
- die URL bereits verlinkt ist,
- der Ankertext kürzer als zwölf Zeichen ist oder „hier“, „mehr“ oder „klicken“ lautet,
- mehr als sechs Links zusammenkämen.
Jede Verwerfung wird protokolliert.
Ich habe ihn mit einem absichtlich fehlerhaften Linkplan gegen den echten Wildbret-Beitrag laufen lassen:
2 interne Links gesetzt | 4 verworfen:
  hier (Ankertext zu kurz)
  Wildbret sicher zerwirken und portionieren (Phrase steht so nicht im Text)
  Eine gute Luftzirkulation ist entscheidend (URL bereits verlinkt)
  Trichinenprobe im Labor (URL nicht in der Kandidatenliste)
Alle vier Fallen haben gegriffen. Die zwei zulässigen Links standen sauber im Text.
Das Prinzip dahinter ist die eigentliche Lehre: Ein Sprachmodell darf vorschlagen, aber nicht ausführen. Der Vorschlag geht durch eine mechanische Prüfung, die nicht verhandelbar ist. Ein Modell, das eine Phrase halluziniert, produziert dann keinen falschen Text, sondern eine Zeile im Protokoll.
Wo die Grenze liegt: lexikalisch, nicht semantisch
Und jetzt die Einschränkung, die dazugehört, weil ich sie sonst verschweigen würde.
Was ich gebaut habe, ist eine lexikalische Annäherung, keine semantische. Der Node vergleicht Wörter und Zeichenfolgen. Er weiß nicht, dass „Wildbret“ und „Fleisch vom Reh“ dasselbe sind. Und er kennt falsche Freunde: Ich musste eigens verhindern, dass Wanderschuhe einlaufen auf Traillaufen verweist.
Was echte semantische Nähe leisten würde, leisten Einbettungen (Embeddings). Der Weg dorthin wäre ein kleiner Nebenworkflow, der täglich alle Beiträge holt, für jeden einen Vektor berechnet und ablegt; im Artikelworkflow wird dann das Thema eingebettet und die nächsten acht Vektoren gezogen. Vier bis fünf Nodes. Einbettungen sind das Billigste, was diese Anbieter verkaufen – bei 1.121 Beiträgen liegt der einmalige Aufbau nach meiner Einschätzung im niedrigen einstelligen Eurobereich. Konkrete Preise nenne ich bewusst nicht, die ändern sich zu schnell.
Ich habe es trotzdem nicht gebaut, und das ist eine bewusste Reihenfolgeentscheidung: Die lexikalische Fassung ist fertig, getestet und braucht keine Zusatzinfrastruktur. Nach den ersten fünfzig Beiträgen sehe ich in der Protokollspalte, wie oft sie danebengreift. Und ich habe die Schnittstelle so gebaut, dass nur dieser eine Node ausgetauscht werden muss – alles danach bleibt unverändert.
Etwas erst dann zu ersetzen, wenn man weiß, ob der Ersatz nötig ist, ist keine Bequemlichkeit. Es ist der Unterschied zwischen bauen und basteln.
Fazit: was der Umbau nicht löst
Ich will nicht mit einem Erfolg enden, wo noch ein Loch ist.
Alles oben betrifft Links, die aus dem neuen Beitrag herausführen. Ein frisch veröffentlichter Beitrag hat null eingehende Links, und daran ändert der Umbau nichts. Über achtzig Wochen wächst so ein Fächer: Die alten Beiträge sammeln alles ein, die neuen bleiben verwaist. Das war der einzige Punkt, an dem die Nachbar-Regel des Clusters tatsächlich etwas geleistet hätte.
Zwei Wege dagegen, in aufsteigender Wirkung und aufsteigendem Risiko:
Ein automatischer „Ähnliche Beiträge“-Block im Theme. (Womit ich mich vor Jahren schon einmal beschäftigt habe, damals auf der Suche nach einer Alternative zu YARPP.) Kostet nichts pro Beitrag, wirkt sofort in beide Richtungen und bleibt richtig, während die Seite wächst. Einschätzung: Solche Blöcke gelten als schwächere Links als Verweise im Fließtext, weil sie auf jeder Seite gleich aussehen – für das Auffinden neuer Beiträge sind sie trotzdem das wirksamste Mittel mit dem geringsten Aufwand.
Rückverlinkung nach dem Veröffentlichen. Der Workflow sucht die ein bis zwei nächsten bereits veröffentlichten Beiträge und setzt dort je einen Link auf den neuen. Technisch machbar. Ich habe es bewusst nicht gebaut: Damit würde eine Automatik bereits veröffentlichte, von mir redigierte Texte verändern. Das würde ich nur mit Sicherungen tun – Änderung ausschließlich an einer klar abgegrenzten Stelle am Textende, Protokoll jeder Änderung, Möglichkeit zum Zurückrollen.
Einen Teil des Problems hat dann übrigens doch noch etwas anderes gelöst, und zwar nebenbei. Im nächsten Teil geht es eigentlich um SEO-Felder und ein WordPress-Verhalten, das mich eine Stunde gekostet hat – aber unterwegs kommt auch der Weiterlesen-Block vor, der neuen Beiträgen wenigstens von ihren Nachfolgern eingehende Links verschafft.
Alle Teile der Serie
- Teil 1: Null Klicks in drei Monaten
- Teil 2: 120 Nodes geerbt
- Teil 3: Schlachttiere im Wildbret-Beitrag
- Teil 4: Vier Beiträge in zwei Sekunden
- Teil 5: Interne Verlinkung, neu gebaut (dieser Beitrag)
- Teil 6: Yoast über die REST-API
- Teil 7: Stil, Modelle und Kosten
- Teil 8: Bilanz nach zwei Tagen
◀ Zurück zu Teil 4: Vier Beiträge in zwei Sekunden | Weiter zu Teil 6: Yoast über die REST-API ▶
[…] Der zweite Hebel liegt außerhalb des einzelnen Beitrags: Verweise deine Beiträge aufeinander, wo es inhaltlich passt. Interne Links helfen Lesern beim Weiterlesen und zeigen der Suchmaschine, welche Seite zu welchem Thema die Hauptseite ist. Wie ich das hier automatisiert habe — und warum der erste Anlauf gescheitert ist — steht im Beitrag zur automatischen internen Verlinkung. […]